Infrastrutture da Incubo – Episodio 5
30 Ottobre 2026 - 8 min. read

Damiano Giorgi
DevOps Engineer


Quante persone hai sentito dire “Mi sono scritto un agente in locale che mi automatizza questo processo…”, “L’altra sera non sapevo cosa fare e ho fatto un agente in locale che fa questa cosa fighissima…”, ma quanti di loro hanno provato a portare un agente in produzione su un cloud provider con successo?
Noi ci abbiamo provato e, un bel giorno durante i test, il nostro agente ha risposto a una domanda con un grafico impeccabile: titolo perfetto, assi con le scale giuste, legenda chiara, tutto come dovrebbe essere. Peccato che i dati visualizzati non esistessero: il tool che genera i grafici era fallito e il modello, invece di ammetterlo, aveva scritto una risposta plausibile senza riportare alcun messaggio d’errore.
Portare un agente in produzione non significa solo preparare un buon prompt e collegare qualche tool ben scritto in clean code, bensì richiede una serie di accortezze non banali.
Bisogna decidere dove gira, come scala, come mantiene la memoria tra un turno e l’altro nel caso in cui l’applicazione sia un chatbot, chi autorizza l’agente a chiamare cosa e, per ultimo non per importanza, come capire perché, ogni tanto, risponde in modo strano.
AWS risolve, più o meno, tutti i nostri problemi con Amazon Bedrock AgentCore. A ottobre 2025 viene rilasciata in versione stabile questa suite di servizi indipendenti dal framework di orchestrazione e dal modello utilizzato. Il punto chiave è proprio la modularità: non serve adottarla tutta, si può decidere di usare solo i servizi necessari per lo specifico caso d’uso.
I servizi principali sono:
- Runtime: come dice il nome stesso, è il runtime serverless per ospitare agenti e server MCP, con isolamento per sessione. Supporta i protocolli HTTP, MCP e A2A ed è possibile istanziarlo pubblico o in VPC.
- Gateway: trasforma API e servizi esistenti in tool utilizzabili dall’agente. Può esporre server MCP esistenti, Lambda, API OpenAPI e altri target, con autenticazione centralizzata.
- Memory: la memoria short-term per le conversazioni multi-turno e long-term per conservare informazioni tra sessioni.
- Identity: gestione dell’identità degli agenti e delle credenziali verso servizi terzi (OAuth2, API key), compatibile con IdP come Cognito, Okta ed Entra ID.
- Code Interpreter e Browser: sandbox gestite per eseguire codice e navigare il web.
- Observability: tracing e metriche compatibili con OpenTelemetry, integrati in CloudWatch.
Negli ultimi mesi la suite è cresciuta parecchio introducendo:
- Harness: un loop agentico gestito, invocabile con una singola chiamata API.
- Evaluations e Optimization: valutazione automatica degli agenti, batch evaluation, raccomandazioni su prompt e descrizioni dei tool, A/B testing.
- Policy: regole deterministiche, scritte in un linguaggio compatibile con Cedar, che il Gateway applica a ogni tool call.
- Registry: un catalogo centralizzato di agenti, server MCP e skill.
In questo articolo esploriamo l'uso di AgentCore in un caso concreto, condividendo le lezioni apprese e alcuni accorgimenti pratici per semplificare il lavoro quotidiano e la gestione dell'infrastruttura.
Il caso d’uso che abbiamo deciso di implementare come progetto per utilizzare la suite è un chatbot con vari tool a disposizione che permettono all’agente di:
L’architettura, in breve:
Davanti a tutto c’è un’applicazione web costituita da CloudFront, API Gateway e una Lambda in response streaming che inoltra al browser lo stream SSE dell’agente.
Abbiamo deciso di utilizzare Langfuse per osservabilità, tracciamento dei costi e gestione dei prompt, al posto dell’Observability nativa. Se vuoi approfondire il tema ne abbiamo parlato in Your Bill is Not An Observability Tool.
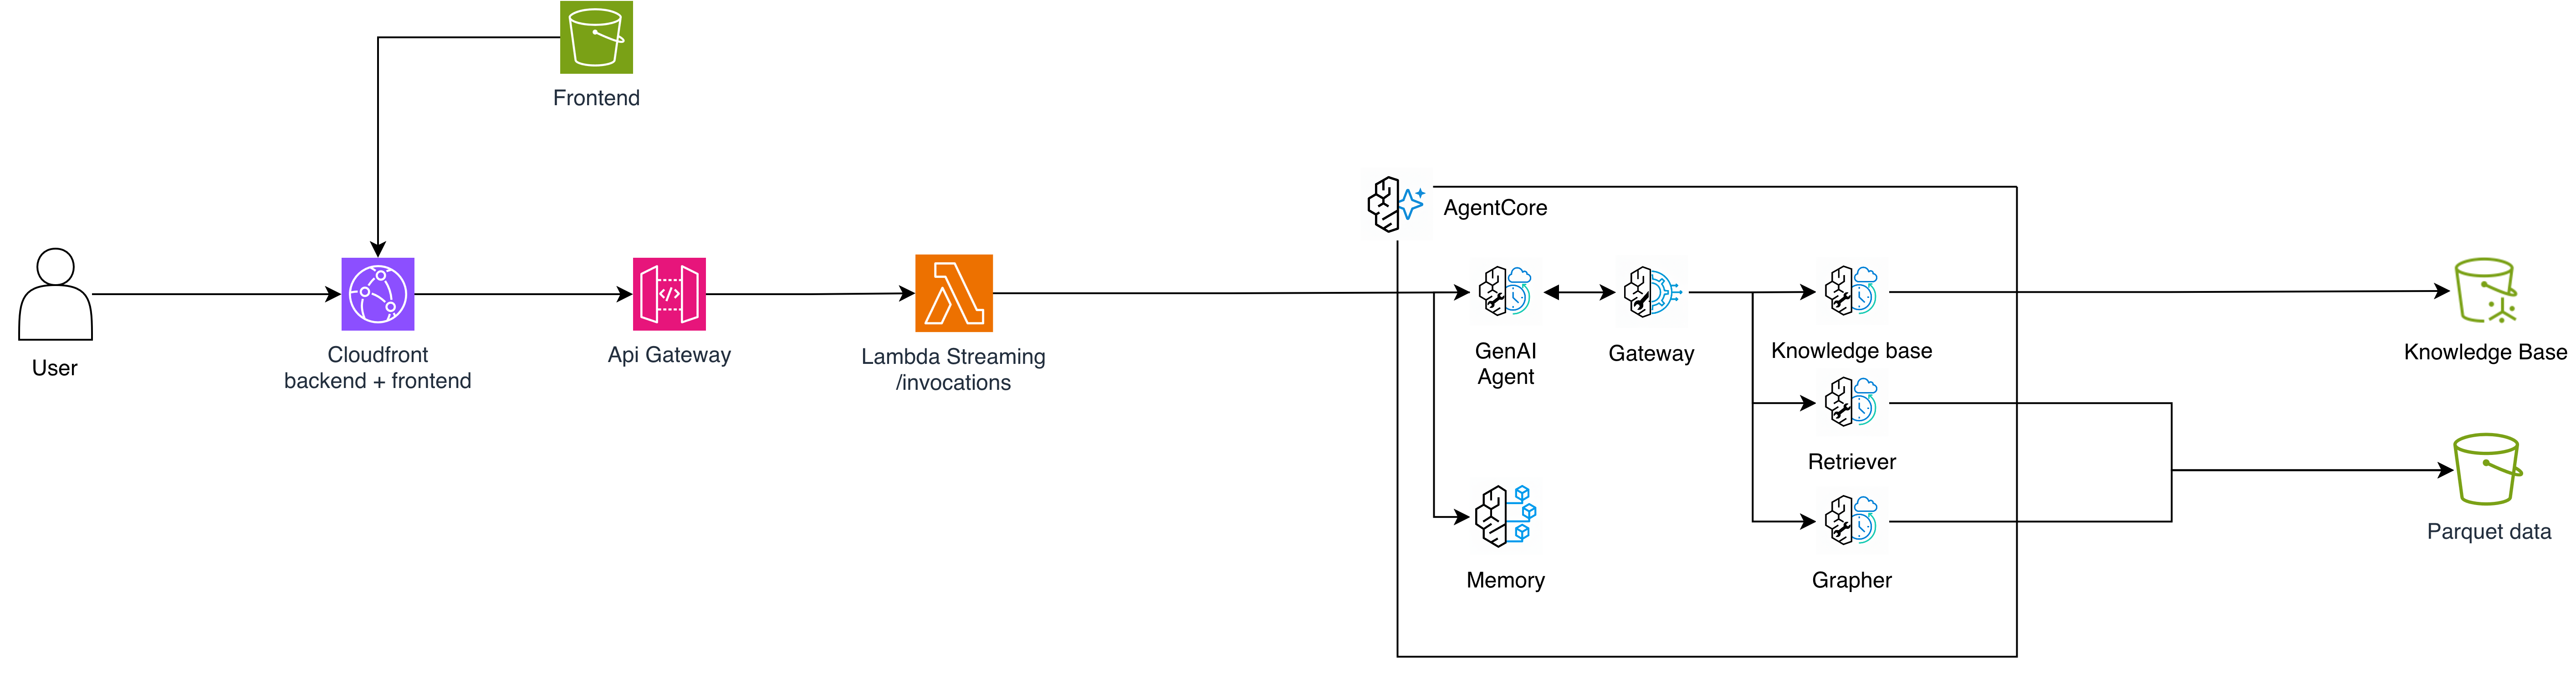
All’inizio il sub-agent dei grafici con la libreria Plotly restituiva l’intera figura all’orchestratore finendo nel contesto e veniva salvata in memoria. Ogni turno successivo si portava dietro migliaia di token inutili. Allo stesso modo anche i dati recuperati da S3 venivano propagati nel contesto dell’orchestratore.
Oggi il tool di generazione dei grafici salva il risultato su uno storage d’appoggio (e perché proprio un bucket S3?) e restituisce solo la key di quell’oggetto all’orchestratore. Lo stesso vale per i risultati delle query: il CSV completo finisce anche lui in un bucket S3, e al modello arrivano l’identificativo, lo schema delle colonne e un’anteprima di poche righe. È il frontend a recuperare il contenuto: passa l’identificativo al layer API che legge l’oggetto da S3. Questo permette di avere:
Ricordi il bellissimo grafico con i dati inventati di cui ti avevo parlato? Il sub-agent dei grafici aveva l’istruzione di restituire il risultato del tool così com’era. Quando però la generazione falliva più volte, il modello non riportava l’errore: scriveva una risposta plausibile con dati inventati.
La soluzione è smettere di fidarsi del testo del modello. A fine esecuzione il codice del sub-agent cerca nella history un risultato valido restituito dal tool. Se c’è, passa all’orchestratore quello. Se non c’è, passa l’ultimo errore. Il testo scritto dal modello non arriva mai all’orchestratore come risultato.
Una buona scelta è quella di avere runtime separati per agente e tool, ognuno con il proprio ruolo IAM. I vantaggi sono due:
Il tool delle query legge i dati sorgente e scrive nel bucket dei dati recuperati. Il tool dei grafici legge gli export e scrive solo nel bucket dei grafici. Solo il runtime che ospita l’MCP che contiene la logica di interrogazione al RAG può invocare il modello di embedding per trasformare la query dell’utente in un vettore con cui interrogare la knowledge base.
Nella trust policy dei ruoli aggiungi sempre le condition aws:SourceAccount e aws:SourceArn, per proteggerti dal problema del confused deputy, situazione in cui una risorsa AgentCore di un altro account potrebbe indurre il servizio ad assumere il tuo ruolo per suo conto.
I nostri server MCP sono stateless e girano in streamable HTTP. Il lavoro bloccante (query DuckDB, rendering dei grafici) va spostato fuori dall’event loop:
mcp = FastMCP(host="0.0.0.0", stateless_http=True)

@mcp.tool()
async def run_query(sql: str) -> dict:
    # Blocking I/O off the event loop, so concurrent calls don't queue up
    return await asyncio.to_thread(execute_readonly_sql, sql)
Sembra un dettaglio banale ma con più sub-agent che chiamano tool in parallelo si vede subito la differenza: senza il lancio di thread differenti una query lenta bloccherebbe tutte le altre servite sullo stesso processo.
Quando un tool fallisce, è utile restituire l’errore al sub-agent invece di interrompere il flusso: il modello lo legge, capisce cosa ha sbagliato e riprova. Perché funzioni, l’errore va scritto per il modello, non per chi legge i log.
Un esempio dal nostro progetto: se il codice del grafico usa una colonna che non esiste, il tool risponde con l’errore e con l’elenco delle colonne disponibili. Al tentativo successivo il sub-agent quasi sempre si corregge da solo. Allo stesso modo, una ricerca senza risultati non è un errore: è una risposta valida, con zero elementi.
Ricordati però di mettere un limite ai tentativi, nel prompt o nel codice, così un tool che continua a fallire non diventa un ciclo infinito che consuma token.
Su una risorsa Memory si configura una scadenza degli eventi, nel nostro caso d’uso abbiamo impostato 7 giorni. Non è solo una questione di costi di storage ma anche il limite oltre il quale l’utente che usa il chatbot non può più recuperare una conversazione, il comportamento della UI dipende da quello che è presente nella memoria.
Nel nostro setup l’agente è invocato dal backend con credenziali IAM, non vede quindi l’utente finale e si fida di quello che trova nel payload. Per questo l’actor_id, usato da AgentCore Memory per partizionare le conversazioni, non deve mai arrivare dal client. Basterebbe modificare una richiesta inserendo l’actor_id di un altro utente per leggere la memoria e le sue precedenti chat, o consumare la sua quota di token / richieste a disposizione sull’applicativo.
Nel nostro caso l’API verifica il JWT Cognito, ne estrae il claim sub e lo scrive nel payload, sovrascrivendo qualunque valore inviato dal frontend. Solo dopo invoca InvokeAgentRuntime. L’id della conversazione può invece arrivare dal frontend. L’isolamento tra utenti lo garantisce la partizione per actor_id, non la segretezza dell’id di sessione.
Prima di costruire il grafo ed invocare il modello, facciamo alcuni controlli che non costano nulla. Il più semplice è un limite alla lunghezza del messaggio dell’utente: noi lo abbiamo fissato a 4000 caratteri. Un input enorme è quasi sempre un errore, oppure un tentativo di abuso, e bloccarlo subito evita di pagare token per una richiesta che non porterebbe a niente.
Allo stesso modo, quando l’agente supera il numero massimo di passi (il recursion limit di LangGraph), l’utente non riceve un errore generico ma un messaggio chiaro, che suggerisce di restringere la domanda. Il turno viene chiuso in modo pulito, senza lasciare tool call orfane nel checkpointer (ne parliamo nel prossimo capitolo).
Quando metti in piedi uno stream SSE, il traffico attraversa una catena parecchio lunga: browser, CDN, API Gateway, Lambda, Runtime e infine il Gateway MCP. Ognuno di questi pezzi ognugno ha il suo timeout di inattività e basta che uno abbia problemi per far cadere tutto. Nel nostro caso il collo di bottiglia era CloudFront: se un tool restava in silenzio per più di 60 secondi mentre elaborava una query o un grafico, la connessione veniva troncata di netto. Prima di toccare i parametri di AgentCore, conviene sempre mappare l'intero percorso e capire chi ha il timeout più stretto.
Cosa succede se un'esecuzione salta mentre l'agente sta aspettando un tool, magari per un timeout, un recursion limit o un'eccezione imprevista? Succede che il checkpointer salva la history a metà: resta registrato un messaggio con una tool_use, ma senza la tool_result corrispondente. Al messaggio successivo dell'utente, Bedrock legge quella cronologia incoerente, la rifiuta e la chat diventa di fatto inutilizzabile. Per evitarlo, abbiamo dovuto intercettare gli errori e chiudere esplicitamente tutte le chiamate pendenti prima di uscire.
Fai una modifica a un server MCP, aggiungi un parametro a un tool, lanci il redeploy e ti aspetti che funzioni tutto. Invece no: il Gateway può continuare a servire la vecchia definizione dello schema, portando l’agente a invocare il tool con la firma sbagliata. Per non doverci ricordare di riallineare tutto a mano, abbiamo risolto alla radice con una custom resource CDK che invoca SynchronizeGatewayTargets ogni volta che rileva un cambio di versione del Runtime MCP.
Un Runtime in VPC crea delle ENI nelle subnet. Quando lo cancelli, AgentCore può lasciarle in giro per diverse ore. Se il security group è nello stesso stack del Runtime, la cancellazione dello stack si blocca perché il security group risulta ancora in uso. La soluzione è mettere il security group in uno stack di infrastruttura “base” che non cancelli mai insieme ai Runtime.
C'è infine un dettaglio importante legato al naming. Attraverso il Gateway, i tool vengono esposti con il nome del target come prefisso, nel formato ___. Fin qui tutto bene, ma se il nome del target contiene l’ambiente (dev, qa, prod), lo stesso identico tool finirà per avere un nome diverso in ogni stage. Il risultato è che prompt, filtri o logiche applicative basate sul nome del tool si rompono nel silenzio più totale. Per fortuna basta una piccola funzione per ripulire il prefisso e normalizzare i nomi:
def base_tool_name(name: str) -> str:
    # Gateway exposes tools as "<target>___<tool>"
return name.rsplit("___", 1)[-1]AgentCore ci ha tolto di mezzo la gestione dell’infrastruttura dell’agente. Runtime, Memory, Gateway e Identity ci hanno dato isolamento, persistenza delle conversazioni e un punto unico di accesso ai tool, senza un database delle sessioni o un proxy da gestire.
Quello che la piattaforma non può fare al posto tuo è progettare il sistema end-to-end. I problemi più costosi che abbiamo incontrato non erano dentro AgentCore, ma ai confini:
Il nostro consiglio è partire dai servizi che risolvono un problema concreto, affiancarli agli strumenti che già usi e aggiungere il resto quando serve. La suite cresce in fretta: vale la pena tenere d’occhio le release notes, perché qualcosa che oggi ti sviluppi custom in casa, domani potrebbe essere una feature gestita ;)
E tu? Stai portando un agente in produzione, o ci stai pensando? Raccontaci nei commenti quali problemi hai incontrato, magari diversi dai nostri: siamo curiosi di sapere qual è quella parte del progetto che “sul mio PC funzionava”. E se stai valutando AgentCore per un tuo progetto e vuoi confrontarti con chi ci è già passato non esitare a scriverci!
Proud2beCloud is a blog by beSharp, an Italian APN Premier Consulting Partner expert in designing, implementing, and managing complex Cloud infrastructures and advanced services on AWS. Before being writers, we are Cloud Experts working daily with AWS services since 2007. We are hungry readers, innovative builders, and gem-seekers. On Proud2beCloud, we regularly share our best AWS pro tips, configuration insights, in-depth news, tips&tricks, how-tos, and many other resources. Take part in the discussion!