Refactoring AI-driven e “Zero-Regression”: mettere in sicurezza il codice con lo Spec-Driven Deve...
14 Ottobre 2026 - 13 min. read
Alessandro Gaggia
Head of Software Development


Bentornati, cari amanti dell'horror. Se seguite questa serie, conoscete già il rito: una volta all'anno si apre la cripta, si rispolverano gli incidenti raccolti durante l'anno e si racconta cosa è andato storto, senza puntare il dito contro nessuno. Il contesto e il tempo spiegano molte decisioni sbagliate. Purtroppo, però, queste scusanti non rendono il billing più leggero.
Questo è l'episodio 5, se vi siete persi i precedenti, vi consigliamo di partire dall'episodio 1, dall'episodio 2, dall'episodio 3 e dall'episodio 4.
Mettetevi comodi e tenete un account break-glass a portata di mano: si comincia!
In Cube, alcune persone si risvegliano in un labirinto di stanze, dove ogni porta sembra un'uscita (ma non lo è). La nostra storia inizia in modo analogo: un'AWS Organization bloccata, senza possibilità di accedervi da nessuna porta.
In questo caso, tutte le scelte erano corrette: IAM Identity Center federato con Microsoft Entra ID, per consentire alle persone di accedere con la propria identità aziendale e ottenere i permission set corretti.
Né il root user né il management account erano in uso, ed è stato creato anche un utente breaking-glass con un hardware MFA token, nel caso in cui un giorno fosse necessario.
Un giorno è scaduto il certificato della federation perché nessuno controllava la mailbox con gli avvisi della health dashboard, e nessuno aveva impostato un allarme sulla scadenza, quindi una mattina la federation ha semplicemente smesso di funzionare e nessun poteva accedere, rendendo quindi necessario mettere in pratica la teoria. La porta di accesso normale non esisteva più.
La prima scelta è stata utilizzare il root user del management account, scoprendo che porta era bloccata, a causa della two factor legata a un numero di telefono gestito centralino VoIP, dismesso all'inizio di quello stesso anno. I codici che sarebbero dovuti arrivare da qualche parte non sarebbero mai potuti arrivare.
Restava l'opzione dell'utente breaking-glass: le credenziali erano salvate nel password manager aziendale. L'unico problema era che la persona che aveva l’unico token fisico per il secondo fattore era in vacanza, ed il token era rimasto a casa, separato da un costoso volo di 10 ore per rientrare, con nessun altra persona che potesse accedervi.
Risultato: circa una settimana senza accessi fuori. Business e servizi hanno continuato a funzionare normalmente e, per fortuna, in quel periodo non ci sono stati incidenti né downtime.
Per favore, non pensate che "la federation è sbagliata": occorre tenere presente che il percorso di recovery fa parte del design di una landing zone. Inoltre, una email non è un sistema valido di monitoring per i certificati in scadenza, e non occorre dipendere da una sola persona o da sistemi esterni per l'MFA.
E, per favore, testate il percorso di recovery,, come dovreste fare con i backup (lo state facendo, giusto?), perché un restore riuscito è l'unica prova che tutto andrà bene quando ne avrete bisogno.
Nel film, Worth aveva ragione su una cosa: se non progettate una via d'uscita, da qui non si esce.
La storia la ricordate: la videocassetta deve continuare a circolare, e se la guardate, l'unico modo per sopravvivere è farne una copia e passarla a qualcun altro.
Ci siamo trovati ad analizzare un'integrazione tra una software house e un sistema di terze parti; sulla carta era un pattern classico: i sistemi si scambiavano messaggi su un bus, con dei webhook a chiudere il cerchio a elaborazione terminata; insomma un caso da manuale di comunicazione asincrona, di cui tutti erano contenti.
Dopo qualche tempo, si è scoperto che il lavoro svolto dal sistema di terze parti era questo:
Non c’era essuna trasformazione utile e nessuna modifica che significasse "fatto", ma solo un'altra copia.
Come per la videocassetta, ricevere il messaggio voleva dire pubblicarlo di nuovo. L'integrazione sembrava lavorare a pieno regime, ma in realtà si stava solo tenendo in vita da sola.
Abbiamo scoperto il loop durante una sessione di debug, perché a causa sua alcuni messaggi venivano persi.
Attenti ai loop (come diceva la canzone di Lucio Dalla): per evitarli potete usare una chiave per tracciare i messaggi, impostare un TTL o applicare qualsiasi altra tecnica utile a identificare i messaggi duplicati e prevenire i loop.
Può sembrare ovvio, ma tenete anche una dead-letter queue monitorata (le vostre DLQ le monitorate, vero?).
In The Ring la maledizione continua ogni volta che qualcuno copia la VHS; la versione cloud è più silenziosa, ma si traduce in costi da paura!
Questa storia non ha bisogno di una citazione d'apertura: il billing fa già abbastanza paura da solo!
Un’azienda voleva modernizzare la sua applicazione CRUD legacy con l’'obiettivo di passare a serverless per ridurre al minimo il lavoro dovuto alle operations, per cui hanno iniziato a guardare a DynamoDB con fiducia e speranza, per il fatto che è gestito, scalabile e con un modello pay-as-you-go, senza un costo fisso per il database.
Il team di sviluppo, però, ha mantenuto il vecchio modello relazionale quasi invariato, forse condizionato da anni di conoscenza del dominio applicativo e dalla conoscenza del prodotto sviluppato. In men che non si dica sono comparse cento tabelle DynamoDB: una per entità, regolate dalle stesse join già presenti.
Anche i pattern di accesso pattern sono rimasti simili a SQL, comportando quindi tante operazioni di Scan e filtrando i dati solo dopo averli già letti.
Nell'ambiente di staging andava tutto bene, ma sappiamo che in produzione i dati crescono, e con loro problemi e costi. Dato che ogni richiesta leggeva più dati del necessario, a fine mese DynamoDB ha avuto un impatto sul billing di circa 13.000$.
Tendiamo sempre a usare la nuova tecnologia che ci piace per qualsiasi cosa, siamo esseri umani e spesso e volentieri quando scopriamo qualcosa di nuovo lo vogliamo usare da subito.
È successa la stessa cosa al team con DynamoDB: hanno iniziato a usarlo ovunque, senza accorgersi di usare un key-value store come un motore relazionale, con tutti gli svantaggi che questo approccio comporta.
Visto che è Halloween, una storia simile la troviamo in Gremlins: in questo caso c’erano delle regole per i Mogwai, come tenerli lontani dalla luce, non bagnarli e non dargli mai da mangiare dopo mezzanotte.
DynamoDB ha regole diverse, ma se le infrangete vi ritroverete un gremlin nel billing: è la scelta migliore se progettate le tabelle in base alle query che vi servono, senza adattarlo al diagramma ER che avete già. Se dovete eseguire query relazionali, meglio usare RDS o Aurora (e ricordate che esiste anche Aurora Serverless). Se per leggere i dati vi affidate agli scan, il vostro tenero animaletto serverless crescerà fino a diventare una fattura con i denti affilati per cibarsi del budget annuale.
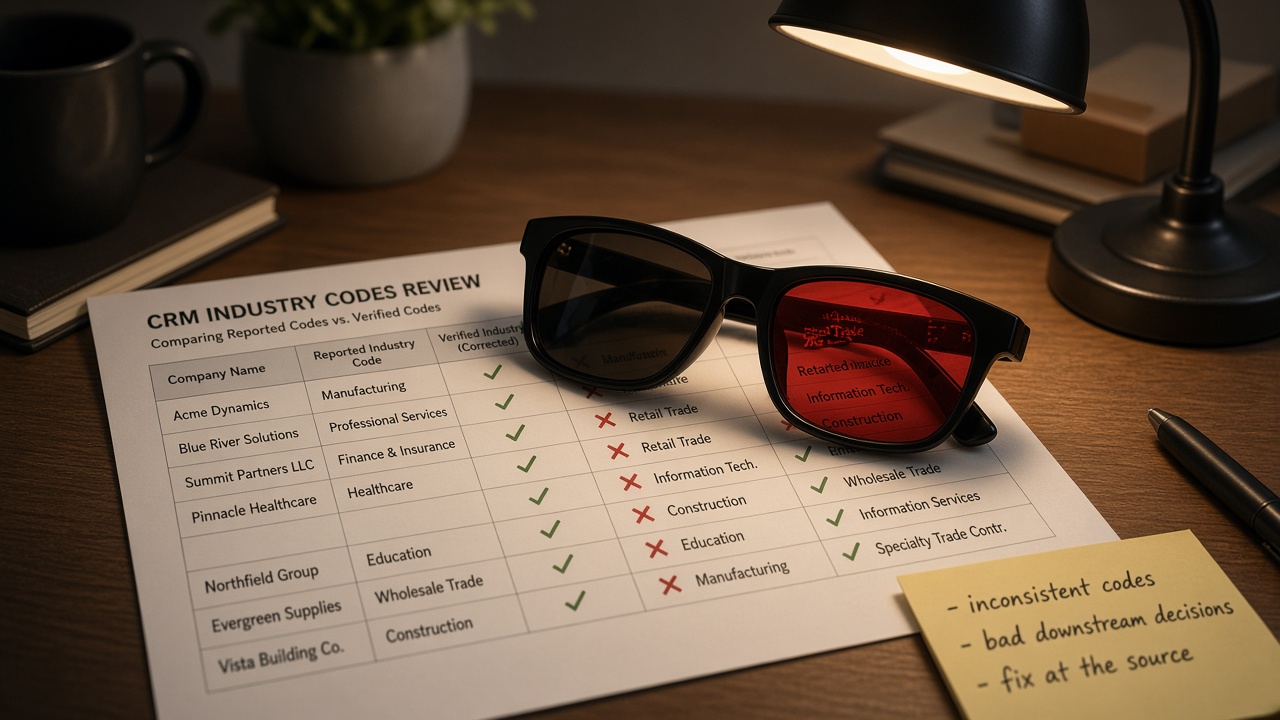
Nel film di john Carpenter basta indossare un paio di occhiali per scoprire che le etichette ufficiali mentivano ed avevano un significato nascosto. Nel nostro caso, non erano scritte, ma dati.
Un team sales aveva bisogno di codici di classificazione settoriale per le aziende presenti nel loro CRM. I codici erano utilizzati per decidere quali proposte mandare ai lead, e per il progetto era stato quindi utilizzato un noto servizio di terze parti per ottenere i codici di classificazione. Sulla carta è una mossa ragionevole: il vendor promette di avere conoscenza completa del mercato, così il feed è diventato la fonte di verità per la classificazione: nessuno metteva in discussione una classificazione precisa e a pagamento.
Ogni tanto, però, dei controlli a campione non erano corretti: una software house risultava un fornitore di cucine industriali, un'altra sembrava a posto finché qualcuno non leggeva la pagina "Chi siamo".La lista di aziende lunga, e la maggior parte delle righe non era ovviamente mai stata verificata, portando a dubbi e incertezze, e un controllo manuale avrebbe richiesto tempi troppo lunghi.
Per risolvere il problema abbiamo pensato di usare l'AI, costruendo un sistema RAG che consultasse la tassonomia ufficiale e i dati pubblici di ogni azienda (nome, sito, breve descrizione) per proporre un codice basato sui dati dell'azienda, da confrontare poi con quello del vendor.
Abbiamo scoperto che per più dell'80% delle aziende in lista il codice del vendor era sbagliato, e quello basato sulla presenza pubblica dell'azienda era migliore.
La parte spaventosa non è che l'AI abbia risolto il problema, ma per quanto tempo le risposte sbagliate siano state usate come se corrette.
Cosa abbiamo imparato? La qualità dei dati conta, ma conta di più avere un modo per verificarla. Nel nostro caso il feed del vendor sembrava essere una verità assoluta, finché non l'abbiamo confrontato con la realtà.
“Rimanogono solo trecentosessantacinque giorni al prossimo Halloween"
Il Sindaco, The Nightmare Before Christmas
In questi anni abbiamo notato uno schema: il problema raramente è un servizio, ma il modo in cui viene usato, monitorato e gestito, e, purtroppo o per fortuna, abbiamo ancora storie per il prossimo anno
Se avete un vostro incubo infrastrutturale (anonimizzato, ovviamente), raccontatecelo nei commenti o contattateci su LinkedIn. Stiamo già prendendo appunti per l'episodio 6.
Ricordatevi di non dare da mangiare alle scan dopo mezzanotte e mettetevi al sicuro. Ci leggiamo il prossimo anno!
Proud2beCloud è il blog di beSharp, APN Premier Consulting Partner italiano esperto nella progettazione, implementazione e gestione di infrastrutture Cloud complesse e servizi AWS avanzati. Prima di essere scrittori, siamo Solutions Architect che, dal 2007, lavorano quotidianamente con i servizi AWS. Siamo innovatori alla costante ricerca della soluzione più all'avanguardia per noi e per i nostri clienti. Su Proud2beCloud condividiamo regolarmente i nostri migliori spunti con chi come noi, per lavoro o per passione, lavora con il Cloud di AWS. Partecipa alla discussione